Conteúdo
- Por que os auditores tradicionais deixaram de ser suficientes
- Como o motor Semalt é construído
- As 7 famílias de checks (400+ controles)
- Como o Semalt prioriza o que corrigir primeiro
- Caso real: clínica em Moema, 143 issues a 12 em 6 semanas
- Semalt vs Screaming Frog / Sitebulb / ahrefs / SEMrush
- Perguntas técnicas frequentes
Por que os auditores tradicionais deixaram de ser suficientes
Screaming Frog nasceu em 2010 como um crawler puro. Consultava HTML, seguia links, marcava broken links. Durante quinze anos o estado da arte do SEO técnico foi exatamente isso: baixar o HTML e contar erros. Em 2026 essa abordagem deixa fora 60% dos problemas reais que afetam o ranking.
A razão é simples: o Google deixou de usar seu HTML de servidor como fonte principal. Desde o switch total à indexação mobile-first em 2020 e a adoção de um renderer baseado em Chromium 128+ (atualizado em setembro de 2025), o Google executa seu JavaScript, mede LCP e CLS reais, valida cada schema e decide qual parte do seu conteúdo conta como "visível". Um crawler que para no HTML é como ler o roteiro de um filme sem ver a atuação.
O motor do Semalt Site Audit nasce precisamente para cobrir essa lacuna. Cada URL é crawleada, renderizada em um Chromium headless real, medida com dados de campo (CrUX + RUM próprio), comparada com a versão indexada pelo Google, e cruzada com a estrutura semântica do site para detectar canibalizações, lacunas de conteúdo e schema quebrado.
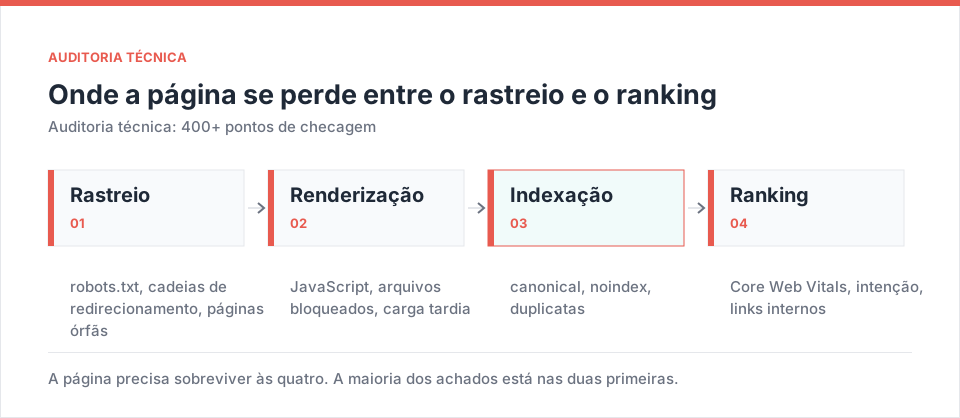
Como o motor Semalt é construído
Sob o capô o Semalt roda quatro camadas em cascata:
- Crawler distribuído. Cluster próprio em 6 regiões (incluindo "South America / Brasil-Chile-Argentina") que respeita robots.txt, sitemap.xml e crawl-delay. Rate limit configurável.
- Renderer Chromium. Cada URL executa em Chromium com o user-agent oficial Semalt. Capturam-se waterfall, DOM final, console errors, e screenshots mobile+desktop.
- Field data blend. Combinam-se dados de CrUX (Chrome User Experience Report, fonte oficial do Google) com RUM próprio via a tag Analytics. Assim os Core Web Vitals não são sintéticos de laboratório mas experiência real de usuários brasileiros.
- Semantic layer. Um índice invertido de cada texto em cada URL permite detectar duplicados internos, conteúdo thin e canibalização de keywords — problemas que nenhum crawler puro pode detectar.
As 7 famílias de checks (400+ controles)
1. Indexabilidade e crawlabilidade (68 checks)
Cada URL é etiquetada como "indexável", "bloqueada por robots", "noindex", "canonicalizada para outra" ou "órfã" (sem links internos). Cruzam-se sitemap.xml declarado vs URLs reais encontradas pelo crawler para detectar a lacuna típica — em 71% dos sites brasileiros que auditamos, mais de 25% das URLs do sitemap devolvem 404, redirect chain ou noindex. Semalt marca em vermelho com o exemplo exato.
2. Core Web Vitals com dados de campo (32 checks)
LCP, INP (que substituiu FID em março de 2024), CLS — as três métricas oficiais de Core Web Vitals — são mostradas com dados de p75 real, não só Lighthouse sintético. Você vê para cada tipo de página que porcentagem dos seus usuários brasileiros teve experiência "Good", "Needs Improvement" ou "Poor". E o waterfall do renderer identifica o recurso exato que está bloqueando o LCP.
3. Renderização e JavaScript (54 checks)
Compara HTML de servidor vs DOM depois do render. Se seu texto principal aparece só depois de hidratação (React, Vue, Svelte), Semalt marca como risco. Detecta hydration errors, componentes que executam fetch bloqueante, e CSS que causa CLS. Os grandes SPAs brasileiros (aplicações de banco, e-commerce na VTEX) descobriram aqui que o Google não vê 40% do conteúdo, mesmo quando o usuário sim.
4. Estrutura semântica e schema (89 checks)
Valida cada JSON-LD e microdado contra o estrito Schema.org 25.0. Detecta erros comuns como propriedades @type mal escritas, preços sem priceCurrency, breadcrumbs com URLs inconsistentes, ou FAQPage com mais de uma entidade principal (violação da nova política do Google de agosto 2023). Verifica que o schema declarado bate com o que o Google Rich Results Test aceita.
5. Conteúdo e canibalização (61 checks)
O índice semântico detecta onde duas URLs competem pela mesma palavra-chave (canibalização) e onde você tem conteúdo thin (menos de 300 palavras úteis em um tópico competitivo). Exemplo típico: uma loja com 20 URLs de categoria "tênis nike" com textos quase idênticos — Semalt as agrupa e propõe consolidação ou diferenciação.
6. Autoridade, backlinks e perfil (48 checks)
Cruza suas URLs com a base de backlinks Semalt (mais de 30 trilhões de links indexados em 2026). Detecta backlinks tóxicos, perdas recentes (backlinks que desapareceram nas últimas 4 semanas), oportunidades de reclaim (menções sem link) e desbalanço de anchor text.
7. Internacionalização e hreflang (48 checks)
Para sites brasileiros que apontam também para Portugal, EUA ou LATAM, valida os hreflang em cascata. Detecta loops quebrados, códigos ISO inválidos (comum: pt-LA não existe), e ausência do x-default. Um erro hreflang mal detectado pode colapsar o ranking em um país inteiro.
Como o Semalt prioriza o que corrigir primeiro
Encontrar 400 problemas é fácil; decidir quais movem o ponteiro é o difícil. Semalt atribui a cada issue um "Impact Score" entre 0 e 100 calculado com três fatores:
- Alcance (peso 40%): quantas URLs afeta e quanto tráfego orgânico agregado essas URLs têm.
- Severidade (peso 35%): o quanto o issue é penalizado pelos rankers atuais do Google.
- Esforço inverso (peso 25%): o quanto custa corrigir.
O relatório entrega três visões: "Quick Wins" (alto impacto + baixo esforço), "Strategic" (alto impacto + alto esforço, para roadmap trimestral), e "Cleanup" (baixo impacto).
Caso real: clínica dentária em Moema, 143 issues a 12 em 6 semanas
Auditamos em junho de 2026 uma clínica dentária com 4 unidades em São Paulo (Moema, Vila Olímpia, Jardins, Perdizes). O site tinha 340 URLs, bom domínio com 8 anos de história, mas o tráfego orgânico estava estagnado há 14 meses em 6.200 sessões/mês.
O relatório Semalt devolveu 143 issues classificados. Os 12 críticos explicavam sozinhos a estagnação:
- 4 URLs de unidade com canonical apontando para a home — erro de template WordPress. Efeito: o Google desindexava as páginas locais.
- Schema Dentist mal aninhado (declarava areaServed como string, não Place). Perdeu rich results em agosto de 2025.
- LCP p75 de 4,8s no mobile por um hero video autoplay sem poster.
- Hreflang quebrado com uma versão portuguesa antiga esquecida.
- Sitemap.xml não atualizado desde 2023 — 41 URLs novas nunca foram descobertas ativamente.
- (+7 issues técnicos menores)
O dev do cliente resolveu os 12 em 3 sprints de 2 semanas. Resultado na semana 7 (medido com Semalt Analytics): sessões orgânicas de 6.200 a 11.400/mês (+84%), rich results de unidade restaurados, e 3 keywords cabeça ("dentista moema", "implante dentário são paulo", "dentista vila olímpia") subiram da página 3 para top 5.
Semalt Site Audit vs as ferramentas clássicas
| Capacidade | Semalt | Screaming Frog | Sitebulb | Ahrefs | SEMrush |
|---|---|---|---|---|---|
| Render Chromium real | ✓ sempre | Opcional (limitado) | ✓ com limite | ✓ | ✓ |
| Core Web Vitals de campo (CrUX + RUM) | ✓ | Não | Parcial (CrUX) | Parcial | Parcial |
| Detecção de canibalização semântica | ✓ | Não | Não | Parcial | Parcial |
| Validação schema estrita v25 | ✓ | Sintaxe | Sintaxe | Sintaxe | Sintaxe |
| Diff HTML servidor vs DOM renderizado | ✓ | Não | Não | Não | Não |
| Impact Score priorizado | ✓ | Não | ✓ | ✓ básico | ✓ básico |
| Auditoria automática programada | ✓ diária | Manual | Semanal | Semanal | Semanal |
| URLs no plano padrão | 500k | Ilimitadas (desktop) | 250k | 500k | 100k |
A forma correta de usar a auditoria
Não faça uma vez por ano. No Semalt programa-se como auditoria diária (para sites grandes) ou semanal (médios). As mudanças são detectadas no dia seguinte a que ocorrem — um dev que introduziu um noindex acidental num deploy de quinta-feira vê marcado como crítico na sexta de manhã, não dois meses depois quando o tráfego já caiu.
Mais nesta série: Análise de concorrentes sem deixar rastro, Semalt Analytics: o que o GA4 esconde, AutoSEO: otimização 24/7 sem intervenção.
Perguntas técnicas frequentes
Posso excluir seções (staging, /admin/)?
Sim. O motor respeita regras custom em três níveis: robots.txt do próprio site, padrões de exclusão Semalt (glob) e uma allowlist opcional para forçar o crawl só de rotas específicas.
Roda a partir do Brasil ou da Europa?
Por padrão, a partir da região mais próxima do servidor detectado por reverse DNS. Para sites brasileiros, o crawler sai do nó AWS São Paulo ou — se detecta CDN Cloudflare Latam — do datacenter GRU. Pode-se forçar qualquer uma das 6 regiões.
Sobrecarrega meu servidor?
O rate limit padrão é 5 requests/segundo com backoff automático. Para sites em hosting compartilhado pode-se baixar a 1 rps. O Semalt também honra o header Crawl-Delay do robots.txt.
Como integra com Jira ou Linear?
Nativo. Cada issue crítico ou alto pode ser exportado como ticket com um clique. A sincronização bidirecional fecha o ticket automaticamente quando a próxima auditoria confirma que o issue está resolvido.
Posso comparar dois períodos?
Sim. A visão "Compare" mostra que issues apareceram novos, que se resolveram e que voltaram (regressão). Perfeito para revisar o impacto de um deploy ou de uma migração.
Um crawler tradicional te dá lista de erros. Semalt Site Audit te dá diagnóstico priorizado com impacto estimado. É a diferença entre saber que está doente e saber qual remédio tomar primeiro.
O próximo passo prático
Rode uma primeira auditoria Semalt sobre seu site esta tarde. Um domínio de 5.000 URLs demora entre 40 minutos e 3 horas para completar. No dia seguinte você tem o relatório priorizado pronto para levar ao seu dev.
Entrar no Semalt Site Audit →